KI-Wissensbasis fürs Marketing aufbauen: So versteht die KI dein Unternehmen
Wie du das Wissen über dein Unternehmen so ablegst, dass die KI bei jeder Aufgabe darauf zugreift und keine Angaben erfinden muss.
Das Wichtigste in Kürze
- Ohne Wissen über Angebot, Positionierung und Zielgruppen füllt die KI Lücken mit Floskeln und erfundenen Angaben.
- Die KI nimmt als gesetzt, was sie liest. In die KI-Wissensbasis schreibst du deshalb auf Dauer nur Freigegebenes ohne Widerspruch.
- Schreib zuerst einen Überblick über dein Unternehmen und lege fest, wann die KI welches Dokument liest und was sie bei Lücken tut.
Ohne Wissen über dein Unternehmen füllt die KI die Lücken mit Allgemeinplätzen und erfundenen Angaben
Ein KI-Modell, etwa Claude oder GPT, weiß aus seinem Training, wie Marketingtexte und Konzepte im Allgemeinen aussehen, aber nichts über dein Unternehmen: euer Angebot und wofür Kunden es einsetzen, eure Positionierung, eure Zielbranchen und die Leute, die bei euren Kunden entscheiden. Dazu kommen die Probleme dieser Entscheider und das Fachwissen aus euren Fachabteilungen.
Die Lücken füllt die KI mit Aussagen, die auf viele Unternehmen passen, oder mit erfundenen Angaben, sogenannten Halluzinationen.
Die Folgen veranschauliche ich an SuperPump, einem erfundenen Hersteller von Industriepumpen, der im ganzen Artikel wiederkehrt.
Angenommen, du machst dort das Marketing. Für die Website schreibt die KI „Wir bieten maßgeschneiderte Lösungen für Ihre individuellen Anforderungen“, und das könnte jeder Anbieter über sich sagen. Für die nächste Kampagne plant sie Anzeigen für „Entscheider in der Industrie“, obwohl bei euren Kunden vor allem die Instandhaltungsleitung den Kauf anstößt. Ähnliches hast du sicher schon erlebt.
OpenAI erklärt im Beitrag „Why language models hallucinate“ (2025), warum Sprachmodelle raten: In Training und Tests bekommt ein Sprachmodell für eine geratene Antwort eine bessere Bewertung als für das Eingeständnis, etwas nicht zu wissen.
Sollen Konzepte, Texte und Kundenansprache zu euch passen, erreichst du mit besseren Prompts und Schreibregeln wenig, solange die KI nichts über eure Produkte und Kunden weiß. Auch ein neuer Kollege ohne Fachwissen schreibt mit Styleguide allein keine guten Fachtexte.
Im Alltag musst du deshalb bei jeder Aufgabe das Fehlende von Hand ergänzen und jede Angabe nachprüfen. Das Ergebnis hängt dann davon ab, woran du bei dieser Aufgabe denkst und wie genau du bist. Diese Handarbeit entfällt erst, wenn die KI das Wissen selbst immer zur Verfügung hat.
Einmal aufgeschrieben und zentral gesammelt, steht das Wissen der KI jederzeit bereit
Am besten schreibst du das Wissen einmal auf und sammelst es an einem Ort, auf den die KI bei jeder Aufgabe zugreift. Dann musst du es ihr nicht jedes Mal neu erzählen, und im Team arbeiten alle mit demselben Wissen.
Auf dem Weg dorthin durchläuft man in der Regel eine Lernkurve mit vier Stufen.
1) Erzählen. Du briefst die KI bei jeder Aufgabe selbst. Was du nicht sagst, fehlt ihr.
2) In den Chat laden. Du gibst der KI Unterlagen zur Aufgabe mit. Für genau diese Aufgabe hat die KI damit, was sie braucht; bei der nächsten musst du die Unterlagen wieder zusammensuchen. Eine Kollegin lädt andere Dateien hoch und bekommt auf dieselbe Frage eine andere Antwort.
3) Alles zentral sammeln. Du lädst alle vorhandenen Unterlagen an einen Ort hoch, auf den die KI bei jeder Aufgabe zugreift, etwa in ein KI-Projekt.
Ein KI-Projekt ist ein Arbeitsbereich, in dem hochgeladene Dateien und dauerhafte Anweisungen für jeden Chat gelten. In dieser Stufe holt sich die KI das Wissen schon selbst, bekommt es aber ungeordnet.
4) Geordnet ablegen. Das Wissen liegt in einer Wissensbasis, geordnet danach, was Fakt ist und wie oft die KI es braucht. Diese Stufe baust du mit diesem Artikel Schritt für Schritt auf.
Im ungeordneten KI-Projekt stützt sich die KI auf alte Fassungen, Entwürfe und Material, das nicht zur Aufgabe gehört
Mit der dritten Stufe machst du einen echten Fortschritt und sparst dir schon viel Zeit, verursachst damit aber andere Probleme.
Wer alle vorhandenen Unterlagen ungeordnet hochlädt, gibt der KI auch alte Fassungen, Entwürfe und fehlerhafte Dokumente. Die KI nimmt als gesetzt, was sie liest. Bei jeder Aufgabe wählt sie selbst, was sie davon nutzt. Daraus entstehen drei Probleme.
Die KI erkennt nicht, welche Fassung gilt. Angenommen, eure Positionierung steht einmal in einer 2 Jahre alten Präsentation und anders in einem neuen Angebot. Selbst wenn die KI das Dateidatum sieht, weiß sie nicht, ob die neuere Fassung die richtige ist.
Die KI behandelt einen Entwurf wie eine Festlegung. Ein hingeworfener Entwurf steht für sie gleichwertig neben einer Aussage, die im Team abgestimmt ist. In Transkripten etwa stehen halbe Gedanken und Missverständnisse wie Feststellungen.
Die KI wählt selbst, welche Unterlagen sie verwendet. Diese Auswahl ist zusätzliche Arbeit für die KI, und wählt sie falsch, werden die Ergebnisse schlechter.
Das zweite Problem, dass die KI einen Entwurf wie eine Festlegung behandelt, habe ich in einem eigenen Kampagnen-Projekt erlebt. Die KI arbeitete dort mit meinen Notizen und mit Zusammenfassungen, die sie selbst geschrieben und ich nur flüchtig gegengelesen hatte.
Im selben Ordner lag der Layoutentwurf einer Landingpage, die sie mit Platzhaltertexten gebaut hatte. Nach mehreren Arbeitsschritten stand plötzlich die Platzhalter-Überschrift als Kernbotschaft im Konzept.
Zum dritten Problem haben Forschende in zwei Untersuchungen an Abrufaufgaben im Labor gemessen, wie stark unpassendes Material die Ergebnisse verschlechtern kann. Laut der Studie „Lost in the Middle“ von Liu u. a. (2023) verwerten Sprachmodelle eine Angabe deutlich schlechter, wenn sie mitten in einem langen Eingabetext steht, wie er bei viel Material entsteht. Im Bericht „Context Rot“ von Chroma (2025) senkte schon ein einzelner themenverwandter Text die Leistung, wenn er die Frage nicht beantwortete.
Was das heißt
Was im KI-Projekt liegt, behandelt die KI als gültig; ohne Vorgabe wählt sie bei jeder Aufgabe selbst aus, worauf sie sich stützt. Alles nur hochzuladen reicht deshalb nicht.
Du musst für die KI erkennbar trennen: auf der einen Seite, was Fakt ist und oft gebraucht wird, auf der anderen alte Fassungen, Entwürfe und selten Gebrauchtes.
Für jedes der drei Probleme gibt es eine eigene Lösung:
- Widersprüchliche Fassungen: Jede Angabe sollte an genau einem Ort stehen.
- Entwürfe, die wie Festlegungen aussehen: Entwürfe und Rohmaterial legst du getrennt von den Unterlagen ab, auf die sich die KI stützt; alles noch nicht Freigegebene kennzeichnest du.
- Falsche Auswahl: Du gibst der KI vor, welche Unterlagen sie bei welcher Aufgabe heranzieht.
Zusammen ergeben die drei Lösungen die Ordnung der Wissensbasis.
Wie baue ich eine Wissensbasis auf, damit die KI mein Unternehmen kennt?
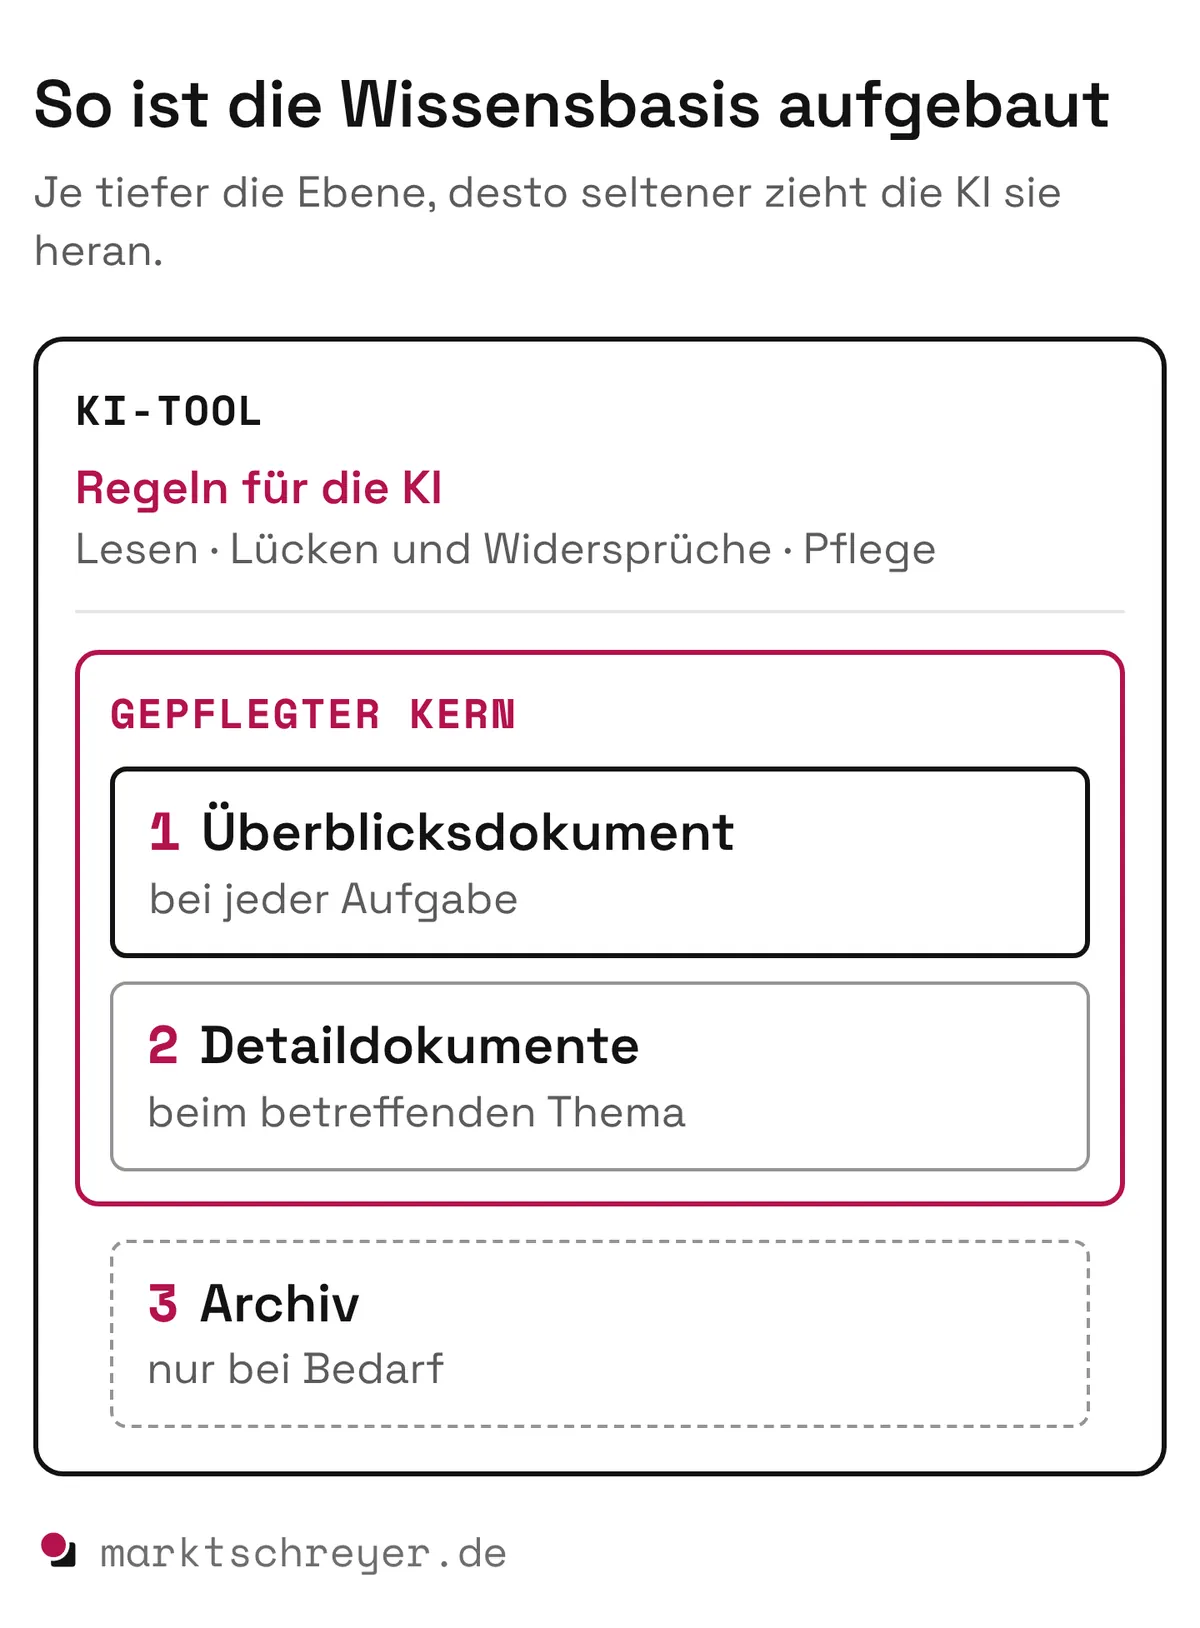
Das Wissen ordnest du in drei Ebenen, die die KI unterschiedlich oft heranzieht:
- Überblicksdokument: was die KI bei jeder Aufgabe braucht
- Detaildokumente: was sie bei häufigen Themen braucht
- Archiv: alles Übrige, das sie nur selten braucht
Dazu schreibst du Regeln für die KI, bindest Dokumente und Regeln dort an, wo sie arbeitet, und hältst Überblicksdokument und Detaildokumente danach aktuell.
 (Bild vergrößern)
Die Ordnung funktioniert wie die Einarbeitung eines neuen Kollegen. Die Einführungsmappe liest er am ersten Tag und die Fachunterlagen, sobald ein Thema ansteht. Im Archiv sucht er nur, wenn ihm etwas fehlt und er tiefer recherchieren muss.
Anthropic empfiehlt im Beitrag „Effective context engineering for AI agents“ (2025) für KI-Agenten denselben Aufbau: einen Teil des Wissens vorab bereitstellen, weiteres bei Bedarf abrufen. Dahinter steht laut Anthropic: Ein Modell kann nur begrenzt viel Text auf einmal berücksichtigen, und jede weitere Angabe bringt weniger zusätzlichen Nutzen.
Überblicksdokument und Detaildokumente bilden zusammen den gepflegten Kern der Wissensbasis. Für den Kern gelten drei Grundsätze:
- Du schreibst nur hinein, was die KI oft braucht, damit sie kein überflüssiges Material lesen muss.
- Du schreibst jede Angabe in genau ein Dokument an eine Stelle, damit keine zweite Fassung entsteht.
- Was auf Dauer im Kern steht, muss freigegeben sein und darf sich nicht widersprechen. Was noch nicht freigegeben ist, kennzeichnest du.
Alles andere legst du ohne Bearbeitung ins Archiv, etwa Transkripte, Präsentationen und Broschüren.
Damit die KI mit dieser Ordnung arbeiten kann, gibst du ihr drei Regelsätze:
- fürs Lesen
- bei Lücken und Widersprüchen
- für die Pflege
In der Leseregel steht, welche Dokumentart, etwa Persona-Dokumente, die KI bei welcher Aufgabe heranzieht; das Archiv zieht sie nur auf Aufforderung heran oder wenn die Angaben im Kern nicht ausreichen.
In der Regel für Lücken und Widersprüche steht, dass die KI nachfragt statt zu raten und welcher Quelle sie bei Widersprüchen folgt.
In den Pflegeregeln steht, wie eine Änderung in den Kern aufgenommen wird. Du brauchst sie, sobald sich an den ersten Dokumenten etwas ändert. Alle drei Regeln betreffen das Wissen der KI und nicht ihre Art zu schreiben.
Personenbezogenes, Vertrauliches und Fremdes prüfst du, bevor es in eine Ebene kommt
Du musst jede Angabe auf drei Arten von Daten prüfen, bevor sie in eine Ebene kommt:
- personenbezogene Daten
- vertrauliche Kunden- und Unternehmensinformationen
- fremdes Material, an dem ihr keine Nutzungsrechte habt
Solche Daten stecken etwa in Transkripten, Angeboten und CRM-Exporten.
Die rechtliche Grenze gilt für alle drei Ebenen. Wo sie liegt, ergibt sich aus Datenschutz und Urheberrecht, aus Verträgen mit Kunden und aus euren eigenen Regeln. Kläre mit der zuständigen Stelle, was bei euch gilt, etwa mit dem Datenschutzbeauftragten. Ich bin kein Jurist.
Ebene 1: Die KI zieht das Überblicksdokument immer heran, deshalb hältst du es kurz
Das Überblicksdokument enthält das Grundwissen über dein Unternehmen. Weil die KI es bei jeder Aufgabe heranzieht, solltest du es so kurz wie möglich halten: als Überblick eben.
Der Umfang richtet sich danach, wie komplex dein Unternehmen ist, etwa wie viele Produkte und Zielsegmente es hat. Als Richtwert reicht bei einem Angebot für eine Zielbranche vielleicht eine Seite; bei vielen Produktlinien und Zielsegmenten können es auch fünf oder mehr Seiten werden.
Das Überblicksdokument von unserem fiktiven Beispiel SuperPump könnte so aussehen:
- Basisfakten: Größe, Standorte, Unternehmensform
- Leistungsbereiche: Produkte, Services, Einsatzfelder
- Positionierung: wofür das Unternehmen steht und was es auszeichnet
- Zielbranchen und Zielunternehmen
- Kundenprobleme und Nutzen
- Personas und Buying Center: Rolle im Kaufprozess, Aufgaben, typische Probleme
- Wissenslandkarte: Verweise auf alle Detaildokumente
Die sieben Abschnitte sind eine Orientierung für den Anfang; du kannst sie ausbauen oder umbauen.
Wie knapp ein Abschnitt sein kann, zeigt der sechste Punkt der Liste, Personas und Buying Center. Bei SuperPump reicht dort zu jeder Persona je eine Zeile, zu Rolle im Kaufprozess, Aufgaben und typischen Problemen, hier für die Instandhaltungsleitung:
6. Personas und Buying Center

Instandhaltungsleitung
Rolle im Kaufprozess: zentrale Fachpersona, oft Treiber bei Ersatz- und Servicebedarf
Aufgaben: Wartung planen, Ausfälle vermeiden, Service koordinieren
Typische Probleme: ungeplante Ausfälle, knappe Ressourcen, schwer planbare Reparaturen
Das ganze Beispiel als Vorlage
Hier steht das vollständige Überblicksdokument des erfundenen Pumpenherstellers SuperPump. Lade es herunter und gib es deiner KI als Vorlage für dein eigenes Überblicksdokument.
Ganze Datei ansehen 00-Ueberblick.md 202 Zeilen
# Überblicksdokument SuperPump

- Zweck: Grundwissen über Unternehmen, Angebot und Zielgruppen für jede Aufgabe der KI
- Stand: 13.04.2026
- Verantwortlich: Marketing / Vertrieb

*Hinweis: SuperPump ist ein erfundener Hersteller von Industriepumpen. Das Beispiel ist KI-generiert, die Inhalte sind generisch. Es zeigt Aufbau und Umfang einer ersten Fassung und ist keine Vorlage dafür, wie die Abschnitte inhaltlich gefüllt sein sollten. Detaildokumente müssen anfangs nicht vorhanden sein; was fehlt, ist in der Wissenslandkarte mit `[offen]` gekennzeichnet.*

## 1. Basisfakten

- Name: SuperPump GmbH
- Sitz: Bremen
- Gründung: 1998
- Mitarbeitende: ca. 420
- Standorte: Bremen, Leipzig, Stuttgart
- Regionen: DACH, Benelux, selektiv Nordeuropa
- Unternehmensform: inhabergeführter Mittelstand
- Geschäftsfeld: industrielle Pumpen und Pumpensysteme für prozesskritische Anwendungen
- Kurzbeschreibung: SuperPump entwickelt, produziert und wartet industrielle Pumpen und anwendungsspezifische Pumpensysteme für industrielle Förderprozesse.

Detaildokumente: `Marke-Unternehmen.md`, `Marke-Positionierung.md`

## 2. Leistungsbereiche

**Produkte und Leistungen**

- Kreiselpumpen für Standard- und Hochlastanwendungen
- Verdrängerpumpen für viskose, abrasive oder sensible Medien
- Dosierpumpen für präzise Medienzugabe im Prozess
- Pumpenskids und Systemlösungen inklusive Steuerung, Sensorik und Peripherie
- Serviceleistungen: Inbetriebnahme, Wartung, Reparatur, Ersatzteile und Retrofit
- technische Beratung und Auslegung für neue Anlagen und Modernisierungen

**Typische Einsatzfelder**

- Wasser- und Medienförderung in Produktionsprozessen
- Dosier- und Umlaufprozesse
- chemische und verfahrenstechnische Anwendungen
- Versorgung kritischer Anlagenbereiche
- Modernisierung bestehender Pumpensysteme
- Effizienzsteigerung und Reduktion von Ausfallrisiken

Detaildokumente: `Produktgruppe-Kreiselpumpen.md`, `Produktgruppe-Verdraengerpumpen.md`, `Produktgruppe-Dosierpumpen.md`, `Produktgruppe-Pumpenskids-Systemloesungen.md`, `Service-Wartung-Instandhaltung.md`, `Service-Retrofit-Modernisierung.md`, `Thema-Technische-Auslegung.md`

## 3. Positionierung

**Value Proposition**

SuperPump unterstützt industrielle Betreiber dabei, Förderprozesse zuverlässig, energieeffizient und wartungsarm zu betreiben. Das Unternehmen verbindet technische Beratung, mittelständische Kundennähe und anwendungsspezifische Systemkompetenz.

**Typische Stärken**

- hohe technische Beratungstiefe
- anwendungsspezifische Auslegung statt reiner Produktverkauf
- schneller Service in der DACH-Region
- Fokus auf Lebenszykluskosten und Anlagenverfügbarkeit
- gute Anschlussfähigkeit an Modernisierungs- und Effizienzprojekte

**Werte und Selbstverständnis**

- verlässlich
- technisch fundiert
- lösungsorientiert
- partnerschaftlich
- pragmatisch

Detaildokumente: `Marke-Positionierung.md`, `Marke-USP-Differenzierung.md`

## 4. Zielbranchen und Zielunternehmen

**Zielbranchen**

- Chemische Industrie
- Wasser- und Abwasserwirtschaft
- Lebensmittel- und Getränkeindustrie
- Pharma / Life Sciences
- Energie- und Umwelttechnik
- Maschinen- und Anlagenbau

**Typische Zielunternehmen**

- mittelständische Produktionsunternehmen
- Betreiber prozesskritischer Anlagen
- Unternehmen mit hohem Verfügbarkeitsdruck
- Werke mit Modernisierungsbedarf in Bestandsanlagen
- Organisationen mit hohen Anforderungen an Sicherheit, Effizienz und Wartbarkeit

Detaildokumente: `Branche-Chemische-Industrie.md`, `Branche-Wasser-Abwasser.md`, `Branche-Lebensmittel-Getraenke.md`, `Branche-Pharma-Life-Sciences.md`, `Branche-Energie-Umwelttechnik.md`

## 5. Kundenprobleme und Nutzen

**Typische Herausforderungen**

- ungeplante Stillstände vermeiden
- Energieverbrauch senken
- veraltete Pumpensysteme modernisieren
- anspruchsvolle Medien sicher fördern
- Wartungsaufwand und Reparaturkosten reduzieren
- Ersatzteil- und Serviceverfügbarkeit sicherstellen
- Investitionen intern wirtschaftlich begründen
- mit knappen Instandhaltungsressourcen zuverlässig arbeiten

**Nutzen durch SuperPump**

- höhere Anlagenverfügbarkeit
- geringere Lebenszykluskosten
- bessere Energieeffizienz
- höhere Prozesssicherheit
- belastbare technische Entscheidungsgrundlagen
- schnellere Reaktion bei Service- und Modernisierungsbedarf

Detaildokumente: `Thema-Anlagenverfuegbarkeit.md`, `Thema-Energieeffizienz.md`, `Thema-Lebenszykluskosten.md`, `Thema-Foerdermedien-und-Auslegung.md`

## 6. Personas und Buying Center

**Technische Leitung / Werksleitung**

- Rolle im Kaufprozess: fachliche Mitentscheidung, Priorisierung von Betriebssicherheit und Wirtschaftlichkeit
- Aufgaben: Anlagenverfügbarkeit sichern, Investitionen bewerten, Risiken minimieren
- Typische Probleme: Stillstände, ineffiziente Altanlagen, hoher Rechtfertigungsdruck bei Investitionen

**Instandhaltungsleitung**

- Rolle im Kaufprozess: zentrale Fachpersona, oft Treiber bei Ersatz- und Servicebedarf
- Aufgaben: Wartung planen, Ausfälle vermeiden, Service koordinieren
- Typische Probleme: ungeplante Ausfälle, knappe Ressourcen, schwer planbare Reparaturen

**Verfahrenstechnik / Engineering**

- Rolle im Kaufprozess: bewertet technische Eignung und Prozessintegration
- Aufgaben: Auslegung, Spezifikation, technische Abstimmung
- Typische Probleme: komplexe Medien, Sonderfälle, Integrationsaufwand

**Einkauf**

- Rolle im Kaufprozess: kommerzielle Bewertung und Lieferantenmanagement
- Aufgaben: Angebote vergleichen, Beschaffung absichern, Verhandlungen führen
- Typische Probleme: Preisvergleich ohne technische Vergleichbarkeit, Lieferzeiten, Total Cost of Ownership schwer bewertbar

**Geschäftsführung / Betriebsleitung**

- Rolle im Kaufprozess: Freigabe bei größeren Investitionen
- Aufgaben: Wirtschaftlichkeit, Risiko und Zukunftsfähigkeit bewerten
- Typische Probleme: Priorisierung von Investitionen, fehlende belastbare Entscheidungsgrundlagen

Detaildokumente: `Persona-Technische-Leitung.md`, `Persona-Instandhaltungsleitung.md`, `Persona-Verfahrenstechnik-Engineering.md`, `Persona-Einkauf.md [offen]`, `Persona-Geschaeftsfuehrung-Betriebsleitung.md`

## 7. Wissenslandkarte

**Unternehmen und Marke**

- Marke-Unternehmen.md
- Marke-Positionierung.md
- Marke-USP-Differenzierung.md
- Glossar.md

**Produktgruppen**

- Produktgruppe-Kreiselpumpen.md
- Produktgruppe-Verdraengerpumpen.md
- Produktgruppe-Dosierpumpen.md
- Produktgruppe-Pumpenskids-Systemloesungen.md

**Services**

- Service-Wartung-Instandhaltung.md
- Service-Ersatzteile-Reparatur.md
- Service-Retrofit-Modernisierung.md
- Service-Inbetriebnahme-Schulung.md

**Branchen**

- Branche-Chemische-Industrie.md
- Branche-Wasser-Abwasser.md
- Branche-Lebensmittel-Getraenke.md
- Branche-Pharma-Life-Sciences.md
- Branche-Energie-Umwelttechnik.md

**Personas**

- Persona-Technische-Leitung.md
- Persona-Instandhaltungsleitung.md
- Persona-Verfahrenstechnik-Engineering.md
- Persona-Einkauf.md [offen]
- Persona-Geschaeftsfuehrung-Betriebsleitung.md

**Fachthemen**

- Thema-Technische-Auslegung.md
- Thema-Anlagenverfuegbarkeit.md
- Thema-Energieeffizienz.md
- Thema-Lebenszykluskosten.md
- Thema-Foerdermedien-und-Auslegung.md

**Archiv**

- Referenzprojekte
- Produktbroschüren
- Serviceberichte
- Präsentationen
- Messeunterlagen
- Gesprächsnotizen und Transkripte
Die Wissenslandkarte zeigt, welche Detaildokumente es gibt und welche noch fehlen
Die Wissenslandkarte ist der letzte Abschnitt des Überblicksdokuments: ein
Verweis auf jedes Detaildokument mit seinem Dateinamen. Fehlt ein Dokument
noch, trägst du den Verweis trotzdem ein und kennzeichnest ihn mit
[offen]. An diesem Kennzeichen erkennt die KI, wo sie nicht raten
soll. In der Wissenslandkarte von SuperPump fehlt etwa noch das
Dokument zur Persona Einkauf:
Personas
- Persona-Instandhaltungsleitung.md
- Persona-Einkauf.md [offen]
Ebene 2: Für jedes Thema schreibst du ein eigenes Detaildokument
Für jedes Thema legst du ein eigenes Detaildokument an, dazu ein Glossar mit den Erklärungen interner Begriffe, Produktnamen und Abkürzungen. Jeder Dokumentart gibst du ein festes Namensmuster.
Bei SuperPump sehen die Dokumentarten und ihre Namensmuster so aus:
- Unternehmen und Marke:
Marke-… - je Persona:
Persona-… - je Zielbranche:
Branche-… - je Produktgruppe oder Leistungsbereich:
Produktgruppe-… - je Servicebereich:
Service-… - je wiederkehrendes Fachthema:
Thema-… - Glossar:
Glossar
Das Überblicksdokument heißt 00-Ueberblick, damit es in jeder
Dateiliste oben steht.
Dokumente derselben Art solltest du gleich aufbauen und nach demselben Muster benennen. Dann behältst du den Überblick, und die KI erkennt leichter, welche Angabe wozu gehört. Anthropic empfiehlt in der Anleitung „Prompting best practices“ (Stand 2026), Inhalte in Prompts mit einheitlich benannten Tags zu gliedern; das verringere Fehldeutungen. Für die Dokumente der Wissensbasis gilt dasselbe Prinzip.
Wie sich Überblicksdokument und Detaildokument die Angaben teilen, zeigen die Personas von SuperPump: Im Überblicksdokument steht zu jeder Persona die Kurzfassung, im Persona-Dokument nur, was darüber hinausgeht. So steht keine Angabe an zwei Stellen.
Das Fachwissen für die Detaildokumente holst du aus zwei Quellen:
- aus Dokumenten, die bei euch schon freigegeben sind
- aus Gesprächen mit den Fachabteilungen und der Geschäftsführung. Lass dir von der KI dazu Fragebögen erstellen.
Ebene 3: Im Archiv sammelst du alles Übrige, und die KI zieht es nur bei Bedarf heran
Ins Archiv legst du unbearbeitet, was du selten brauchst, etwa:
- Pressemitteilungen und Blogartikel
- Case Studies
- alte Präsentationen
- Transkripte, die die rechtliche Prüfung bestanden haben
Laut Leseregel zieht die KI das Archiv nur heran, wenn du sie dazu aufforderst oder die Angaben im Kern nicht ausreichen. Funde aus dem Archiv kennzeichnet sie nach der Regel für Lücken und Widersprüche und fragt bei dir nach.
Das Archiv legst du in einen angebundenen Ordner und nicht ins KI-Projekt. Dateien, die du ins KI-Projekt hochlädst, gehören zum Projektkontext; die KI kann sie bei jeder Aufgabe heranziehen. Das ungeordnete Archiv stünde dann gleichrangig neben dem gepflegten Kern und das willst du nicht.
Einen angebundenen Ordner durchsucht die KI dagegen nur, wenn eine Aufgabe es verlangt, und holt nur die passenden Abschnitte.
Als angebundener Ordner eignen sich drei Orte:
- eure Cloud-/Server-Ablage, etwa SharePoint oder Google Drive, über einen Connector
- ein Ordner, den deine KI-Plattform selbst synchronisiert und durchsucht
- ein lokaler Ordner auf deinem Rechner, den du der KI bei Bedarf freigibst
Erste Wahl ist eure bestehende Ablage: Dann muss niemand eine zweite Kopie pflegen, und die Menge spielt keine Rolle. Die beiden anderen Orte kommen infrage, wenn dein Werkzeug keinen Connector hat oder ihr keine zentrale Ablage habt.
Was in den Kern kommt, prüfst du und schreibst es nach festen Regeln
Ins Archiv legst du Unterlagen so, wie sie sind. Für den Kern gelten strikte Regeln:
- welche Fakten auf Dauer in den Kern dürfen
- wie du kennzeichnest, was vorübergehend noch nicht freigegeben ist
- wie du die Dokumente schreibst
Auf Dauer schreibst du in den Kern nur, was freigegeben ist und sich nicht widerspricht
Die KI nimmt als gesetzt, was im Kern steht; deshalb musst du jede Angabe prüfen, bevor sie dort auf Dauer stehen bleibt. Laut der Studie „Adaptive Chameleon or Stubborn Sloth“ von Xie u. a. (2024) übernehmen Sprachmodelle zusammenhängende und überzeugende Angaben aus ihren Unterlagen auch dann, wenn diese ihrem eigenen Wissen widersprechen.
In den Kern dürfen deshalb auf Dauer nur Fakten, die diese drei Bedingungen erfüllen:
- freigegeben
- widerspruchsfrei
- oft gebraucht
Freigegeben heißt: im Team abgestimmt oder von den Verantwortlichen bestätigt sowie für längere Zeit gültig.
Die folgenden Inhalte gehören nicht in den Kern, weil sie keine Fakten sind oder gegen eine der Bedingungen verstoßen:
- Arbeitsanweisungen sind keine Fakten; sie gehören in die Aufgabe oder in die Projektanweisung.
- Was sich laufend ändert, etwa Termine und laufende Kampagnen, müsstest du ständig pflegen.
- Dubletten widersprechen sich, sobald sich eine Fassung ändert.
- Veraltetes ist nicht mehr freigegeben.
- Einzelfälle ohne allgemeine Aussage, etwa ein einzelnes Kundenprojekt, werden nicht oft gebraucht.
- Werbesprache ohne Fakt dahinter liest die KI als Zusage.
Den Unterschied zwischen Werbesprache und Fakt aus dem letzten Punkt der Liste zeigt das Überblicksdokument von SuperPump: „robuste Lösungen für anspruchsvolle Industrieumgebungen“ wäre Werbesprache, „Kreiselpumpen für Standard- und Hochlastanwendungen“ dagegen ein Fakt, mit dem die KI arbeiten kann.
Mit Kennzeichen darf Unabgestimmtes in den Kern, bis es freigegeben ist
Mittelfristig sollten im Kern nur freigegebene Fakten stehen. Vorübergehend kannst du noch nicht Freigegebenes oder Annahmen in den Kern schreiben, um Lücken zu füllen.
Voraussetzung ist, dass du kennzeichnest, wie weit eine Angabe gesichert ist:
| Kennzeichen | Was es heißt | Woran du es erkennst |
|---|---|---|
[zusammengetragen] |
aus vorhandenem Material übernommen, noch nicht bestätigt | Du kennst die Quelle, aber niemanden, der die Angabe bestätigt hat |
[vermutet] |
plausibel, aber unbelegt | Du würdest im Gespräch „ich glaube“ davorsetzen |
[offen] |
fehlt, bewusst als Lücke gekennzeichnet | Du müsstest raten, um den Satz zu vervollständigen |
So sieht ein Zwischenstand im Überblicksdokument von SuperPump mit allen drei Kennzeichen aus:
Zielbranchen: Chemie, Wasser und Abwasser, Lebensmittel und Getränke, Pharma, Energie- und Umwelttechnik, Maschinen- und Anlagenbau
Instandhaltungsleitung oft Treiber bei Ersatz- und Servicebedarf [zusammengetragen]
Investitionsbereitschaft im Mittelstand höher als im Konzern [vermutet]
Marktanteil in Österreich: [offen]
Eine Zeile ohne Kennzeichen gilt als freigegeben. In der Regel für Lücken und Widersprüche legst du fest, wie die KI mit gekennzeichneten Angaben umgeht. Ist der Kern komplett freigegeben, brauchst du Kennzeichen nur noch dort, wo etwas Neues dazukommt.
Die Dokumente schreibst du trocken, eindeutig und in Stichpunkten
Die Dokumente schreibst du trocken und eindeutig, damit die KI jede Angabe nur auf eine Weise lesen kann. Für jedes Dokument gilt:
- in Stichpunkten, so kurz wie möglich und so ausführlich wie nötig
- ein Begriff je Sache, erklärt im Glossar
- Fakten neutral beschrieben, mit Quelle, wo eine Zahl oder ein Fakt einen Beleg braucht
- in Word oder Markdown, einer einfachen Textauszeichnung
- mit einem Kopf aus Zweck, Stand und Verantwortlichkeit
Warum es nur einen Begriff je Sache geben soll, zeigt SuperPump: Heißt dort dieselbe Reihe von Kreiselpumpen einmal „X-Serie“ und einmal „Baureihe X“, weiß die KI nicht, ob es dieselbe Reihe ist.
Word oder Markdown eignen sich, weil du in der Aufbauphase ständig etwas änderst und jeder im Team solche Dateien herunterladen, bearbeiten und weitergeben kann.
Folien und gestaltete PDFs solltest du in Text überführen, sobald du sie regelmäßig brauchst. Das Umwandeln kann die KI übernehmen; prüfen musst du das Ergebnis selbst. Die Textfassung legst du in den Kern, das Original ins Archiv.
Den Kopf aus dem letzten Punkt der Liste bilden die drei Angaben
Zweck, Stand und Verantwortlich:
- Zweck: Positionierung und Kernbotschaften
- Stand: 04.03.2026
- Verantwortlich: Marketing
Zu jeder Zahl gehört ein Datum, entweder am Wert oder für den ganzen Abschnitt. Steht im Kopf ein Kennzeichen für das ganze Dokument, kennzeichnest du am einzelnen Satz nur, was davon abweicht.
Jetzt weißt du, was in den Kern kommt und wie du seine Dokumente schreibst. Offen ist noch, womit du anfängst.
Für die erste Fassung schreibst du das Überblicksdokument und die Regeln für die KI
Für eine erste Fassung, mit der die KI arbeiten kann, brauchst du nur das Überblicksdokument, die Leseregel und die Regel für Lücken und Widersprüche. Liegen dir schon freigegebene Unterlagen vor, steht diese Fassung in etwa einem halben Tag. Fehlen sie, dauert es länger, weil ihr die Inhalte erst im Team abstimmen müsst.
Archiv, Detaildokumente und Pflegeregeln kannst du in den Wochen danach ergänzen, jeweils dann, wenn du sie brauchst.
Steht bei SuperPump etwa als Nächstes eine Kampagne für die Wasser- und Abwasserwirtschaft an, wird dieses Branchendokument zuerst geschrieben.
So legst du die Wissensbasis an
Mit den Schritten 1 bis 4 steht eine erste Fassung, mit der die KI arbeiten kann.
Erste Fassung:
-
Überblicksdokument schreiben.
Du schreibst das Grundwissen zu Unternehmen, Angebot und Zielgruppen auf, das die KI bei jeder Aufgabe braucht. Am Ende vermerkst du, welche weiteren Dokumente es gibt, welche noch kommen und welche Angaben noch fehlen.
-
Regeln für die KI schreiben.
Du legst fest, welche Dokumente die KI wann heranzieht und wie sie mit fehlenden oder widersprüchlichen Angaben umgeht.
-
Dokumente der KI zur Verfügung stellen.
Du lädst die Dokumente dort hoch, wo die KI arbeitet, etwa in ein KI-Projekt, und gibst ihr die Regeln als dauerhafte Anweisung.
-
Gegenprobe machen.
Du gibst der KI eine typische Aufgabe ohne weitere Angaben und prüfst, was im Ergebnis fehlt. Das trägst du dann nach bzw. merkst es vor.
In den Wochen danach:
-
Übrige Unterlagen in einem eigenen Ordner sammeln.
Du legst alle weiteren Unterlagen in einen Ordner, den die KI nur bei Bedarf durchsucht.
-
Detaildokumente schreiben.
Du schreibst Dokumente zu einzelnen Themen wie Personas, Branchen oder Produktgruppen, jeweils dann, wenn du sie brauchst.
-
Regeln für Änderungen festlegen.
Du legst fest, wie neues Wissen in die Dokumente kommt, ohne dass Widersprüche entstehen.
Fertig ist die erste Fassung, wenn diese vier Bedingungen erfüllt sind:
- Jeder Punkt der Wissenslandkarte verweist auf ein Dokument oder ist als Lücke gekennzeichnet.
- Alles nicht Freigegebene ist gekennzeichnet.
- Kern und Regeln liegen dort, wo die KI arbeitet.
- Die Gegenprobe ist gemacht und die Ergebnisse sind eingearbeitet.
Start und Dauer richten sich danach, was schon vorliegt
Dein Start hängt stark davon ab, was schon vorhanden ist:
1) Freigegebene Unterlagen liegen vor. Aus ihnen lässt du die KI mit dem SuperPump-Beispiel als Vorlage die erste Version des Überblicksdokuments bauen.
Diese Version ist eine Arbeitsversion, die du prüfen musst, bevor du sie übernimmst. Ansonsten stehen im Kern Angaben, die für deine Aufgaben nicht relevant sind oder deren Herkunft niemand kennt.
Eure Website oder Präsentationen eignen sich als Quelle nur, wenn dort Fakten stehen; steht dort nur Werbesprache, startest du wie in Fall 2.
Die übrigen Unterlagen legst du später ins Archiv. Für die erste Fassung brauchst du etwa einen halben Tag.
2) Kein oder wenig freigegebenes Material. Manchmal gibt es nicht einmal eine gemeinsam abgestimmte Positionierung oder Angebotsbeschreibung. Jeder formuliert die Dinge etwas anders.
Du holst dir erst mal die wichtigsten Infos in Gesprächen mit Fachabteilungen und Geschäftsführung und sammelst vorhandene Unterlagen zusammen. Daraus schreibst du die erste Fassung. Lücken bei wichtigen Infos füllst du mit begründeten Annahmen. Kennzeichne jede nicht freigegebene Stelle und Lücke nach der Anleitung oben. Ein solches Dokument ist immer noch besser als nichts.
Wie lange es dauert, in Fall 2 alles Nötige zusammenzutragen und abzustimmen, kann ich nicht vorhersagen: Tage, Wochen oder auch Monate.
Mit zwei Regeln legst du fest, wie die KI mit der Wissensbasis arbeitet
Für die erste Fassung schreibst du zwei der drei erforderlichen Regeln: die Leseregel und die Regel für Lücken und Widersprüche. Beide gelten für jede Aufgabe.
In der Leseregel legst du fest, welche Dokumentart die KI bei welcher Aufgabe heranzieht
Die Leseregel schreibst du einmal, mit einer Zeile je Dokumentart: wann die KI sie heranzieht.
Im KI-Projekt kann die KI alles Hochgeladene heranziehen; mit der Leseregel bestimmst du, welche dieser Dateien sie für eine Aufgabe heranzieht und in welcher Reihenfolge.
In der Leseregel stehen Dokumentarten, in der Wissenslandkarte einzelne Dokumente. Eine neue Zeile in der Leseregel brauchst du deshalb nur bei einer neuen Dokumentart.
Eine Leseregel zum Kopieren, mit den Namensmustern von SuperPump:
Lies bei jeder Aufgabe zuerst 00-Ueberblick.md.
Zieh Marke-*.md heran, sobald es um Positionierung oder Botschaften geht.
Zieh Persona-*.md heran, sobald die Aufgabe eine Zielgruppe betrifft.
Zieh Branche-*.md heran, sobald eine Branche genannt ist.
Zieh Produktgruppe-*.md und Service-*.md heran, wenn die Aufgabe genau dieses Angebot betrifft.
Zieh Thema-*.md heran, sobald die Aufgabe das Fachthema berührt.
Nutze Glossar.md für jeden internen Begriff.
Halte dich bei jeder Änderung an Pflegeregeln.md.
Durchsuche das Archiv nur auf meine Aufforderung oder bei einer Lücke im Kern.
Die Namensmuster musst du an deine eigenen Dateinamen anpassen. Die Zeile zu den Pflegeregeln ergänzt du, sobald es sie gibt.
Bei Lücken fragt die KI nach, bei Widersprüchen folgt sie einer Rangfolge
Mit der Regel für Lücken und Widersprüche legst du fest, was die KI in drei Fällen tut:
- Lücke: Sie sucht im Archiv, kennzeichnet Gefundenes und fragt dich.
- Widerspruch: Sie folgt einer Rangfolge und meldet, was sie nicht auflösen kann.
- Alte Zahl: Sie spricht das Datum an und arbeitet weiter.
Bei einem Widerspruch gilt diese Rangfolge:
- freigegebene Dokumente des Kerns
- benannte und datierte Primärquellen, etwa ein Transkript, das du für die Aufgabe hochlädst
- alles aus dem Archiv
Das Kennzeichen an einer Angabe geht dieser Rangfolge vor. Das zeigt die
Zeile mit [vermutet] aus dem Zwischenstand von
SuperPump: „Investitionsbereitschaft im Mittelstand höher als im
Konzern“ bleibt eine Vermutung, obwohl das Überblicksdokument zum Kern
gehört.
Widersprechen sich zwei Dokumente des Kerns, liegt ein Pflegefehler vor, den die KI meldet. Widersprechen deine Angaben im Chat den Dokumenten, fragt sie nach, welche Angabe für die Aufgabe gilt.
Wie die Rangfolge greift, zeigt ein Fall bei SuperPump: Im Überblicksdokument stehen ca. 420 Mitarbeitende, im hochgeladenen Transkript eines Interviews mit der Geschäftsführung 450. Dann gilt das Überblicksdokument, und die KI weist dich auf den Unterschied hin, damit du den Kern prüfst.
Beim dritten Fall, der alten Zahl, hängt es von der Art der Zahl ab, ab wann sie als alt gilt; das kannst du in dieser Regel je Zahlenart festlegen. Die Regel zum Kopieren setzt ein Jahr als Auffanggrenze, damit niemand mit sehr alten Zahlen arbeitet: Ist das Datum älter, arbeitet die KI weiter und weist dich darauf hin, damit du die Zahl prüfst.
Hält sich die KI an diese Regel, fragt sie nach, statt zu halluzinieren. Anthropic empfiehlt in der Anleitung „Reduce hallucinations“ (Stand 2026), der KI ausdrücklich zu erlauben, Unsicherheit zuzugeben; das könne falsche Angaben deutlich verringern.
Die Regel zum Kopieren gehört direkt unter die Leseregel:
Findest du im Kern kein Dokument zu einem Thema oder eine Angabe mit [offen]:
Durchsuche das Archiv, sofern es angebunden ist. Kennzeichne Gefundenes
als [zusammengetragen] und frag mich. Fülle die Lücke nicht selbst.

Angaben mit [vermutet] verwendest du nicht als Fakt.
Angaben mit [zusammengetragen] verwendest du nur mit einem Hinweis darauf.

Widersprechen sich zwei Angaben, gilt diese Rangfolge:
1. freigegebene Dokumente des Kerns
2. benannte und datierte Primärquellen
3. das Archiv
Ein Kennzeichen an der Angabe geht dieser Rangfolge vor.
Widersprechen sich zwei Dokumente des Kerns, sag es mir.
Weicht eine Primärquelle vom Kern ab, folge dem Kern und sag es mir.
Widersprechen meine Angaben im Chat den Dokumenten, frag nach,
welche Angabe für diese Aufgabe gilt.

Ist das Datum einer Zahl älter als ein Jahr und für diese Art von Zahl
nichts anderes festgelegt, sag es einmal und arbeite weiter.
Kern und Regeln bindest du in dem KI-Werkzeug an, mit dem du arbeitest
Damit die KI Kern und Regeln bei jeder Aufgabe heranzieht, bindest du beides in dem KI-Werkzeug an, mit dem du arbeitest. Infrage kommen drei Orte:
- ein KI-Projekt
- ein Ordner, den ein KI-Agent liest
- später ein Skill
Im KI-Projekt lädst du die Dokumente des Kerns hoch und setzt die beiden Regeln in die Projektanweisung: das Feld für Anweisungen, die in jedem Chat des Projekts gelten.
Im KI-Projekt hat damit jeder Bestandteil seinen Ort:
| Bestandteil | Ort |
|---|---|
| Dokumente des Kerns | als Dateien im KI-Projekt oder in einem angebundenen Ordner |
| Leseregel und Regel für Lücken und Widersprüche | Projektanweisung |
| Pflegeregeln | eigenes Dokument neben dem Kern, bei wenigen Regeln in der Projektanweisung |
| Archiv | Ablage mit Connector, sonst ein anderer angebundener Ordner |
Teilst du das KI-Projekt, arbeiten alle im Team mit derselben Wissensbasis.
Ist der Kern komplett freigegeben und änderst du nur noch Kleinigkeiten, kannst du die Dokumente in einen Skill überführen. Warum das sinnvoll ist und wie es geht, würde hier zu weit führen.
Prüfe, ob die erste Fassung funktioniert
So prüfst du, wie gut du mit der ersten Fassung des Überblicksdokuments arbeiten kannst:
- Stell der KI eine typische Aufgabe, ohne ihr Inhalte dazu mitzugeben, z. B. eine Konzeptentwicklung oder einen Text.
- Prüf, ob das Konzept zu euren Zielgruppen und eurer Positionierung passt und ob der Text konkrete Angaben über euch enthält.
- Fehlt etwas, ergänz die Angabe im Kern und kennzeichne sie, bis sie freigegeben ist.
Nach meiner Erfahrung werden die Arbeitsergebnisse der KI sofort besser, weil sie mehr über das Unternehmen weiß und du es ihr nicht bei jeder Aufgabe neu erzählen musst.
Bei SuperPump würde sich das an den Beispielen vom Anfang des Artikels zeigen: Statt Anzeigen für „Entscheider in der Industrie“ richtet sich das Kampagnenkonzept jetzt an die Instandhaltungsleitung. Und statt „maßgeschneiderter Lösungen“ nennt der Website-Text, für welche Medien die Pumpen ausgelegt sind.
Damit die KI auch dann passende Ergebnisse liefert, wenn sich bei euch etwas ändert, musst du den Kern weiter pflegen.
Nach dem Aufbau schließt du Lücken und trägst Änderungen nach
Nach der ersten Fassung musst du dich noch um Folgendes kümmern:
- Lücken erkennen: Musst du der KI bei einer Aufgabe eine Angabe über euch mitgeben, etwa einen Produktnamen, eine Zielbranche oder eine Zahl, fehlt sie im Kern. Ergänz sie dort und kennzeichne sie, bis sie freigegeben ist.
- Lücken schließen: Was als
[offen],[vermutet]oder[zusammengetragen]gekennzeichnet ist, klärst du nach und nach. Dabei gehst du so sorgfältig vor wie beim Aufbau und nimmst das Kennzeichen erst weg, wenn die Angabe freigegeben ist. - Änderungen nachtragen: Ändert sich etwas, etwa ein Produkt, eine Zielbranche oder eine Zahl, trägst du es ein.
- Den Kern schützen: In den Kern schreibt nur, wer die Pflegeregeln kennt, und auch die KI trägt nichts ungeprüft ein.
Mit dem vierten Punkt verhinderst du, dass die Probleme aus dem ungeordneten KI-Projekt zurückkommen. Schreiben ungeschulte Personen in den Kern oder lässt jemand die KI ungeprüft Angaben eintragen, stehen dort bald wieder Dubletten, Entwürfe und Widersprüche. Stelle Richtlinien dafür auf oder schränke die Schreibrechte an den Dateien ein.
Die KI pflegt nach den Pflegeregeln, du gibst nur frei
Für dich heißt Pflegen, eine Änderung durchzugeben und freizugeben; die übrige Arbeit kann die KI nach den Pflegeregeln übernehmen.
Die Pflegeregeln legst du als eigenes Dokument neben den Kern. Sie legen fest, wo eine Änderung hinkommt, was bei einem Widerspruch geschieht und was die KI mitändert, wenn ein Dokument dazukommt, wegfällt oder umbenannt wird. Pflegeregeln zum Kopieren:
Wenn ich eine Änderung durchgebe:
1. Steht die Angabe schon im Kern, ändere diese Stelle.
   Leg keine zweite an.
2. Widerspricht die Änderung einer bestehenden Angabe,
   entscheide nicht selbst, welche gilt, sondern frag mich.
3. Schreib die neue Angabe in Form und Umfang wie die
   Angaben daneben.
4. Kennzeichne, was noch nicht freigegeben ist.
   Jede neue Zahl bekommt ein Datum.
5. Kommt ein Dokument dazu, benenne es nach dem Muster
   seiner Dokumentart und trag es in die Wissenslandkarte ein.
   Ist es eine neue Dokumentart, ergänze die Leseregel.
6. Wird ein Dokument gelöscht, verschoben oder umbenannt,
   passe jeden Verweis darauf an, auch in Wissenslandkarte
   und Leseregel.
7. Setz den Stand im Dokumentkopf nur hoch, wenn das ganze
   Dokument geprüft ist.
8. Zeig mir jede Änderung, bevor sie in den Kern kommt.
   Nenne offene Punkte, statt sie selbst zu entscheiden.
Die Regel zum Stand verhindert ein falsches Signal: Setzt die KI das Datum bei jeder kleinen Änderung hoch, sieht das ganze Dokument geprüft aus, obwohl nur eine Zeile neu ist.
Darüber hinaus gehst du den Kern von Zeit zu Zeit einmal ganz durch und
setzt danach den Stand hoch. Wie oft, richtet sich danach, wie
schnell sich euer Bereich ändert: in schnelllebigen Bereichen etwa
halbjährlich, in langsameren seltener. Nach größeren Änderungen machst du
zusätzlich die Gegenprobe.
Den Aufbau der Wissensbasis machst du einmal
Je nachdem, wie viel bei euch schon abgestimmt und dokumentiert ist, kann der Aufbau einer Wissensbasis viel Arbeit sein. Aber du machst sie nur einmal.
Ohne Wissensbasis briefst du die KI bei jeder Aufgabe neu und musst mittelmäßige oder falsche Ergebnisse selbst überarbeiten. Die Wissensbasis ist die Grundlage für effizientes Arbeiten mit KI im Marketing und später für jede Automatisierung. Wie eine solche Automatisierung aussieht, zeigt mein Film zum Blog-Artikel-Prozess: Die Skills lesen dort Personas, Einwände und Case Studies aus der Wissensbasis von Phocus Direct.
Unabhängig von KI-Tools sollten Fakten wie Angebot, Positionierung, Zielgruppen und die Probleme eurer Kunden ohnehin einmal sauber abgestimmt und dokumentiert sein. Fehlt das bei euch bisher, ist ein KI-Projekt eine gute Gelegenheit, es anzugehen.
Häufige Fragen
Was ist eine Wissensbasis für KI im Marketing?
Eine Wissensbasis für KI im Marketing ist eine geordnete Sammlung von Dokumenten mit dem Wissen über dein Unternehmen, das eine KI für Marketingaufgaben braucht: Angebot, Positionierung, Zielgruppen und die Probleme eurer Kunden. Sie besteht aus einem kurzen Überblicksdokument, das die KI bei jeder Aufgabe liest, aus Detaildokumenten zu einzelnen Themen und aus einem Archiv für alles Übrige. Mit einer Leseregel legst du fest, welche Dokumente die KI bei welcher Aufgabe heranzieht, mit einer Regel für Lücken und Widersprüche, was sie tut, wenn etwas fehlt. So musst du die KI nicht bei jeder Aufgabe neu briefen, und sie fragt bei Lücken nach, statt Angaben zu erfinden.
Was gehört in eine Wissensbasis für KI im Marketing?
In den Kern einer Wissensbasis für KI im Marketing gehören auf Dauer nur Fakten, die im Team freigegeben sind, sich nicht widersprechen und bei vielen Aufgaben gebraucht werden. Dazu zählen etwa Angebot und Einsatzfelder, Positionierung, Zielbranchen, Personas und die Probleme eurer Kunden. Nicht hinein gehören Arbeitsanweisungen, Inhalte, die sich laufend ändern, Dubletten, veraltete Fassungen, Einzelfälle und Werbesprache ohne Fakt dahinter. Noch nicht Freigegebenes darf vorübergehend hinein, wenn es gekennzeichnet ist; Präsentationen, Transkripte und anderes Material legst du unbearbeitet in ein Archiv, das die KI nur bei Bedarf durchsucht.
Reicht es, alle Unterlagen in ein KI-Projekt hochzuladen?
Nein: Wer alle Unterlagen ungeordnet in ein KI-Projekt hochlädt, gibt der KI auch alte Fassungen, Entwürfe und fehlerhafte Dokumente, und die KI behandelt alles dort als gültig. Sie erkennt nicht, welche von zwei Fassungen gilt, nimmt Entwürfe als Festlegung und wählt selbst, worauf sie sich stützt. Besser legst du ins KI-Projekt nur geordnete Dokumente, in denen Ungeprüftes gekennzeichnet ist, gibst der KI vor, welche sie bei welcher Aufgabe heranzieht, und sammelst alles Übrige in einem Ordner, den sie nur bei Bedarf durchsucht.